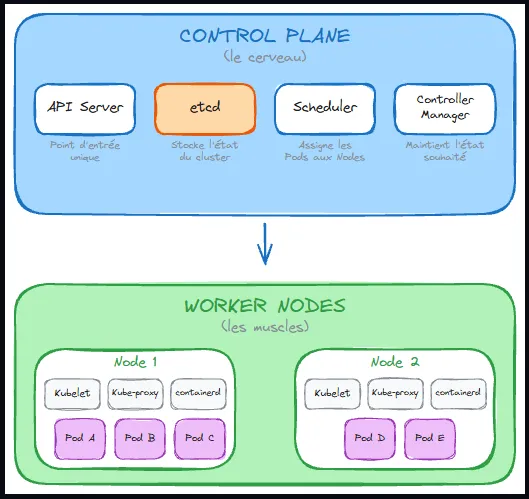
Un cluster Kubernetes se divise en deux parties : le control plane, qui décide, et les worker nodes, qui exécutent.
Tout passe par l’API Server : kubectl, les contrôleurs, le Scheduler et les kubelets ne se parlent jamais directement. L’état du cluster est stocké dans etcd. Chaque composant observe l’état souhaité et agit pour que l’état réel le rejoigne : c’est la boucle de réconciliation.
Les composants observent l’API Server, pas etcd. Personne d’autre que l’API Server ne sait où est etcd, ni comment lui parler.
De même, les kubelets fonctionnent en mode « pull » : ils interrogent régulièrement l’API Server plutôt que d’attendre des ordres.
Séparer le control plane des worker nodes rend le cluster extensible, résilient et protégeable.
Extensible
Pour gagner en capacité, il suffit d’ajouter des worker nodes : ils s’enregistrent auprès de l’API Server et le Scheduler commence aussitôt à leur confier des Pods. Le control plane n’a pas à être modifié, et il peut lui-même être renforcé de son côté, indépendamment des workers.
Résilient
Une panne d’un côté n’emporte pas l’autre. Si un worker tombe, le control plane le détecte et recrée ses Pods sur les autres nodes. Si le control plane tombe, les applications déjà lancées continuent de tourner sur les workers (voir plus bas).
Protégeable
Le control plane détient ce qui est sensible : etcd et ses Secrets, et les droits sur tout le cluster. Séparé des workers, il peut être isolé : machines dédiées où ne tourne aucune application, accès réseau restreint à l’API Server, etcd joignable uniquement par l’API Server. Une application compromise sur un worker n’a donc pas d’accès direct au cœur du cluster.
Le control plane prend les décisions pour l’ensemble du cluster. Il ne fait tourner aucune application lui-même.
API Server
Le point d’entrée unique du cluster. Il reçoit toutes les requêtes (de kubectl comme des autres composants), vérifie les droits, valide les objets puis les enregistre dans etcd. C’est le seul composant qui lit et écrit dans etcd.
etcd
La base de données clé-valeur qui stocke l’état du cluster : tous les objets (Deployments, Pods, Services, Secrets…) y sont enregistrés. C’est la source de vérité : perdre etcd sans sauvegarde, c’est perdre le cluster.
Scheduler
Il assigne les Pods aux Nodes. Pour chaque Pod qui n’a pas encore de node, il choisit le plus adapté selon les ressources demandées et les contraintes de placement. Il ne démarre pas le Pod : il note seulement sur quel node il doit tourner.
Controller Manager
Il maintient l’état souhaité. Il regroupe les contrôleurs (Deployment, ReplicaSet, Node…) qui comparent en permanence l’état réel à l’état demandé et corrigent les écarts : recréer un Pod qui a disparu, signaler un node qui ne répond plus…
C’est le composant qui rend Kubernetes auto-correctif : il réconcilie en permanence l’état souhaité avec l’état actuel, grâce à une boucle de contrôle :
watch (observe l’état via l’API Server) → compare (souhaité vs actuel) → act (corrige l’écart)
Il regroupe plusieurs contrôleurs spécialisés dans un seul processus :
Un composant optionnel, qui n’existe que sur les clusters déployés chez un fournisseur cloud (AWS, GCP, Azure…). C’est l’un des composants d’intégration.
Il n’est nécessaire que si le cluster a besoin de ressources chez le fournisseur : load balancer, route, disque… Il faut alors lui configurer les droits IAM associés.
La communication entre composants : le modèle pull
Dans Kubernetes, ce sont les composants qui appellent l’API Server, et non l’inverse : les kubelets vont eux-mêmes chercher ce qu’ils doivent faire. Conséquence : une panne du control plane ne coupe pas les applications déjà lancées (voir plus bas).
Un worker node est une machine physique ou virtuelle où s’exécutent les Pods. Chaque node porte trois composants qui collaborent pour faire tourner les applications :
kubelet
L’agent de Kubernetes sur le node. Il récupère auprès de l’API Server les Pods qui lui sont assignés, demande au runtime de démarrer leurs conteneurs, vérifie qu’ils restent en bonne santé et remonte leur état. Parle à : l’API Server (pull) et le runtime (CRI).
kube-proxy
Il traduit les Services en règles réseau sur le node, pour que le trafic envoyé à l’adresse d’un Service arrive bien sur l’un de ses Pods. Parle à : l’API Server (watch des EndpointSlices).
Runtime de conteneurs
C’est lui qui télécharge les images et lance réellement les conteneurs (containerd, CRI-O). Parle à : le kubelet, via le CRI.
Côté node aussi, c’est le modèle pull : le kubelet et kube-proxy interrogent régulièrement l’API Server pour connaître l’état désiré, au lieu de recevoir des ordres poussés. Seule exception : la connexion de l’API Server vers le kubelet pour les logs et l’exec.
Le composant central du node : il transforme les spécifications de Pods reçues de l’API Server en conteneurs réellement exécutés sur la machine. Sa boucle :
Watch l’API Server pour connaître les Pods assignés à son node.
Crée ou supprime les conteneurs via le runtime (CRI).
Surveille la santé des conteneurs (probes).
Reporte l’état du node et des Pods à l’API Server.
Un Static Pod est un Pod géré directement par le kubelet, et non par l’API Server. Au lieu d’attendre un kubectl, le kubelet surveille un dossier sur le disque du node : dès qu’un fichier YAML y apparaît, il tente de lancer le Pod.
Impossible de deviner où est ce dossier : il faut le demander à la configuration du kubelet.
Terminal window
grepstaticPodPath/var/lib/kubelet/config.yaml
Ce dossier est vital : c’est lui qui permet de démarrer le cluster sans API Server. Pour avoir un API Server, il faut un cluster ; pour avoir un cluster, il faut un API Server. Les Static Pods cassent ce cercle.
Le CRI (Container Runtime Interface) est l’interface standardisée entre le kubelet et le runtime. Le kubelet ne crée jamais un conteneur lui-même : il émet une demande normalisée en gRPC et délègue tout le reste au runtime. C’est cette indirection qui permet de remplacer containerd par CRI-O sans toucher au kubelet.
Le kubelet apprend par l’API Server qu’un Pod doit tourner sur son node.
Il appelle le runtime via le CRI pour télécharger l’image, créer puis démarrer le conteneur.
Le runtime crée le conteneur avec les namespaces et les cgroups Linux.
Plusieurs runtimes peuvent jouer ce rôle :
Runtime
Description
Statut
containerd
Léger, prêt pour la production. Le plus répandu, utilisé par la plupart des distributions et des offres cloud (GKE, EKS, AKS, Kind, k3s). Né chez Docker, il est aujourd’hui un projet indépendant de la CNCF.
par défaut depuis Kubernetes 1.24
CRI-O
Conçu uniquement pour Kubernetes : il implémente le CRI et rien de plus. Utilisé notamment par Red Hat OpenShift.
alternative
Docker Engine + cri-dockerd
Le moteur Docker complet. Il n’implémente pas le CRI : Kubernetes ne peut l’utiliser qu’à travers un adaptateur externe, cri-dockerd.
Il gère les règles réseau qui font fonctionner les Services :
il watch les Services et les EndpointSlices via l’API Server ;
il configure les règles réseau pour router le trafic vers les bons Pods ;
il répartit le trafic entre les Pods d’un même Service.
Il s’exécute comme un DaemonSet : un Pod sur chaque node du cluster, y compris ceux ajoutés plus tard. Tous les nodes savent ainsi router le trafic vers les Services.
Mode
Statut
iptables
par défaut sur Linux, convient à la très grande majorité des installations
L’idée clé : Kubernetes définit des interfaces mais ne les implémente pas lui-même. Des composants externes s’en chargent. C’est ce qui permet au même cluster de tourner sur un poste de travail comme chez un fournisseur cloud, avec les mêmes objets.
CNI — le réseau
Container Network Interface. Donne une adresse IP aux Pods et leur permet de communiquer entre eux. Où : un plugin sur chaque nœud. Exemples : Calico, Cilium, Flannel.
CSI — le stockage
Container Storage Interface. Fournit les volumes persistants demandés par les Pods. Où : un contrôleur, et un plugin sur chaque nœud. Exemples : les drivers des fournisseurs cloud, Longhorn.
Cloud Controller Manager — le cloud
Fait le lien avec le fournisseur cloud : load balancers, disques, informations sur les machines. Où : côté control plane.
Ingress Controller — le trafic HTTP
Applique les règles HTTP/HTTPS déclarées dans les objets Ingress. Où : dans le cluster, sous forme de Pods. Exemples : Traefik, HAProxy.
Un objet Kubernetes sans le composant qui l’implémente ne fait rien. C’est l’erreur de débutant la plus courante.
Kubernetes impose une règle réseau simple : chaque Pod a sa propre adresse IP et peut joindre n’importe quel autre Pod, même sur un autre nœud, sans traduction d’adresse. Mais il ne la met pas en œuvre lui-même : c’est le rôle du plugin CNI.
À chaque création de Pod, le runtime appelle le plugin CNI, qui :
crée l’interface réseau du Pod et lui attribue une adresse IP ;
installe les routes pour que le Pod soit joignable depuis les autres nœuds ;
pour certains plugins, applique aussi les NetworkPolicies, les règles qui filtrent le trafic entre Pods.
Plugin
Points forts
Cas d’usage typique
Calico
Mature et performant. Gère complètement les NetworkPolicies, et y ajoute ses propres règles plus fines. Peut router sans tunnel (BGP) ou avec.
Clusters de production, sur site ou dans le cloud, qui ont besoin de règles de sécurité réseau.
Flannel
Très simple et léger, presque rien à configurer. En revanche, il n’applique pas les NetworkPolicies.
Petits clusters, labs, apprentissage. C’est le CNI par défaut de k3s.
Cilium
Basé sur eBPF (programmes exécutés dans le noyau Linux) : très performant, règles de sécurité jusqu’au niveau HTTP, observabilité du trafic avec Hubble. Peut remplacer kube-proxy.
Grands clusters de production, besoins avancés en sécurité ou en observabilité.
Kindnet
Minimal, installé automatiquement par Kind : aucune configuration.
kubectl apply -f deployment.yaml envoie le manifeste à l’API Server, qui le valide et l’enregistre dans etcd.
Le contrôleur de Deployment, dans le Controller Manager, voit ce nouveau Deployment et crée un ReplicaSet. Le contrôleur de ReplicaSet crée à son tour les Pods. Ils n’ont pas encore de node : ils sont en Pending.
Le Scheduler repère ces Pods sans node, choisit un node pour chacun et enregistre ce choix via l’API Server.
Le kubelet du node choisi voit qu’un Pod lui est assigné. Il demande à containerd de télécharger l’image et de démarrer les conteneurs.
Le kubelet remonte l’état du Pod à l’API Server : le Pod passe en Running. Si un Service sélectionne ce Pod, kube-proxy met à jour les règles réseau pour lui envoyer du trafic.
Les Pods déjà lancés continuent de tourner : les kubelets et containerd n’ont pas besoin du control plane pour faire vivre les conteneurs existants. En revanche, plus rien ne change : impossible de déployer, de mettre à l’échelle, et un Pod qui plante sur un node tombé n’est plus recréé ailleurs.
C’est pourquoi, en production, le control plane est réparti sur plusieurs machines (généralement 3), avec etcd répliqué entre elles.